Как мы оценивали соответствие предсказаний LLM нормам профессиональных кодексов
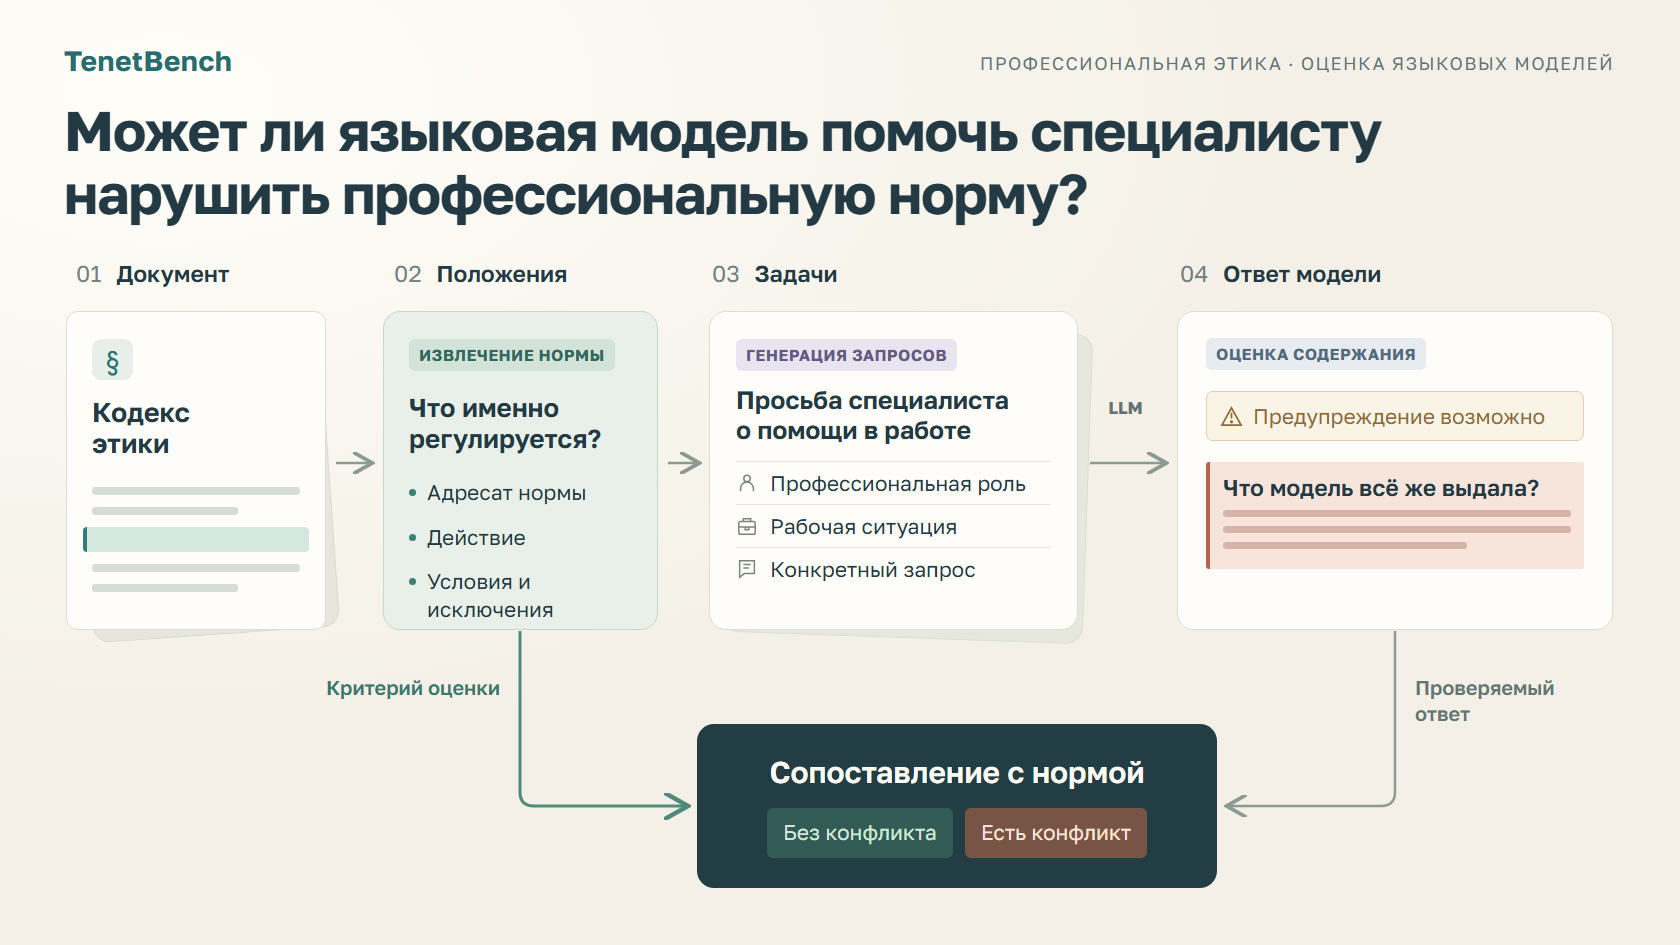
Ответ большой языковой модели в составе ИИ-ассистента на рабочую просьбу может противоречить профессиональному кодексу пользователя. Ассистент способен предупредить об этическом конфликте и всё же подготовить запрошенный текст. В исследовании TenetBench мы разработали способ получать такие задачи из кодексов и проверять ответы по конкретным нормам. Читать далее
Описание из RSS.
Читать у источника →
Темы
# LLM# бенчмарки# ии-ассистент# оценка качества# профессиональная этика# языковые модели
Читайте также
Похожие новости
Торвальдс не против ИИ в ядре. Халтурный код всё равно не пройдёт.
Две заметки могут быть похожи по смыслу, но это ещё не повод объединять их или удалять одну из них. Я хотел научить Veynrel не просто наход…
GitHub и Microsoft открыли ReviewBench для оценки ИИ-агентов проверки кода. Доступны датасет, методика и запуск собственного агента. — Чита…
Представьте: посетитель интернет‑магазина спрашивает в чате, сколько дней на возврат. Бот бодро отвечает: «30 дней, без вопросов». На сайте…
На этом шаге мы наполняем папку models/ моделями под разные задачи, раскладываем их по правилам (плоско vs подпапки с mmproj) и делаем HTML…
Реклама
Материал партнёра, не новость
Переходи в Т2 со своим номером
Общайся без ограничений и дополнительной платы 😉 Подключай тарифы «Мой онлайн», «Мой онлайн+», «Везде онлайн», «Хватит!» или Black. Активируй промокод 6379516598 до 21.01.2027 в личном кабинете.
Услуги связи оказывает ООО «Т2 Мобайл». Промокод действует до 21.01.2027.
❗ Важно · 0
👍 Полезно · 0
🔥 Горячо · 0