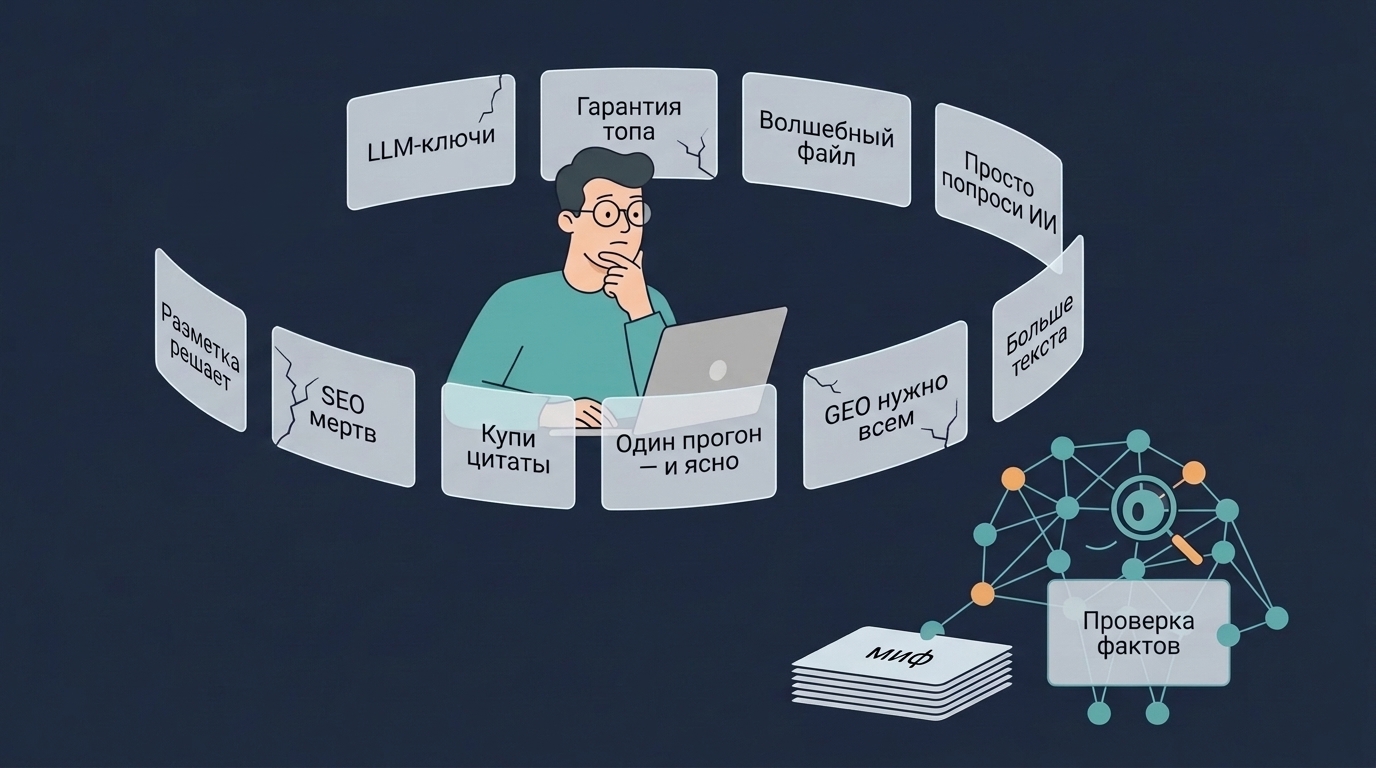
Рынок продвижения в ответах нейросетей (GEO) переполнен предложениями, которые часто путают технические задачи с дорогими ритуалами. Владелец сайта может столкнуться с рекомендациями подрядчиков добавить файл llms.txt, переписать контент под специальные ключи или купить гарантированное место в рекомендациях. Однако реальность такова, что поисковые роботы нейросетей не могут корректно прочитать сайт, если у него есть классические проблемы: закрытые правила в robots.txt, клиентский рендеринг контента или ошибки разметки. Фундаментальные требования к доступности и машиночитаемости остаются прежними, а не вводят новую науку, требующую полного отказа от опыта классического SEO.
Существует убеждение, что наличие файла llms.txt автоматически гарантирует попадание в ответы нейросетей. На деле этот файл является лишь рекомендацией, а не рейтинговым фактором, и ни один провайдер не обязуется учитывать его при отборе источников. Если модель физически не может дойти до страницы из-за технических ограничений, файл llms.txt не поможет. Кроме того, около трети таких файлов не проходят валидацию из-за битых ссылок или отсутствия обязательных секций. Делать файл стоит как полезную карту для навигации, но ожидать от него мгновенных продаж ошибочно.
Миф о существовании особых «LLM-ключевых слов» также не соответствует действительности. Нейросети используют семантический поиск и векторное сопоставление смыслов, а не ищут точные вхождения фраз. Плотность ключевых слов здесь не играет роли. Для цитируемости важны сами по себе понятные абзацы, четкая иерархия заголовков, конкретные данные (цифры, цены, даты) и актуальность информации. Секрет успеха заключается в написании структурированных текстов для людей, которые машина может легко извлечь, без использования специальных заклинаний.
Другие распространенные заблуждения включают веру в то, что микроразметка FAQ гарантирует цитирование, или что можно «уговорить» модель через скрытые промпты и инструкции на странице. Разметка Schema.org помогает извлекать факты, но не влияет на решение модели о релевантности источника. Попытки внедрить инструкции в диалог модели или использовать скрытый текст не работают из-за контекста разговора пользователя и мер безопасности провайдеров. Истинная репутация формируется через внешние сигналы: отзывы, упоминания в СМИ и обсуждения в сообществах.
Покупка гарантированных позиций в ответах нейросетей невозможна, так как нет единого рейтинга, а модели недетерминированы и дают разные ответы в разное время. Провайдеры не продают места в отборе источников, как это делается в контекстной рекламе. Единственная честная гарантия, которую может дать подрядчик, — это оплата услуг. Для оценки видимости нельзя делать выводы по одному запросу; необходимо проводить системные замеры с фиксированным списком запросов и отслеживать динамику метрик, таких как доля цитирований и соотношение упоминаний с конкурентами.
Наконец, отсутствие переходов с chatgpt.com в аналитике не означает провал стратегии GEO. Ссылки внутри текстовых ответов могут не иметь меток utm_source, маскируясь под прямой трафик. Более того, работает сценарий zero-click, когда пользователь получает ответ с названием бренда и запоминает его, переходя на сайт позже через обычный поиск. Также ошибочно считать, что чем больше текста, тем выше шансы на цитирование; нейросети ценят экспертность и структуру, а не просто объем контента.