[Перевод] Выжимаем максимум из BERT: токенизация в 50 раз быстрее

Источник
[Перевод] Выжимаем максимум из BERT: токенизация в 50 раз быстрее

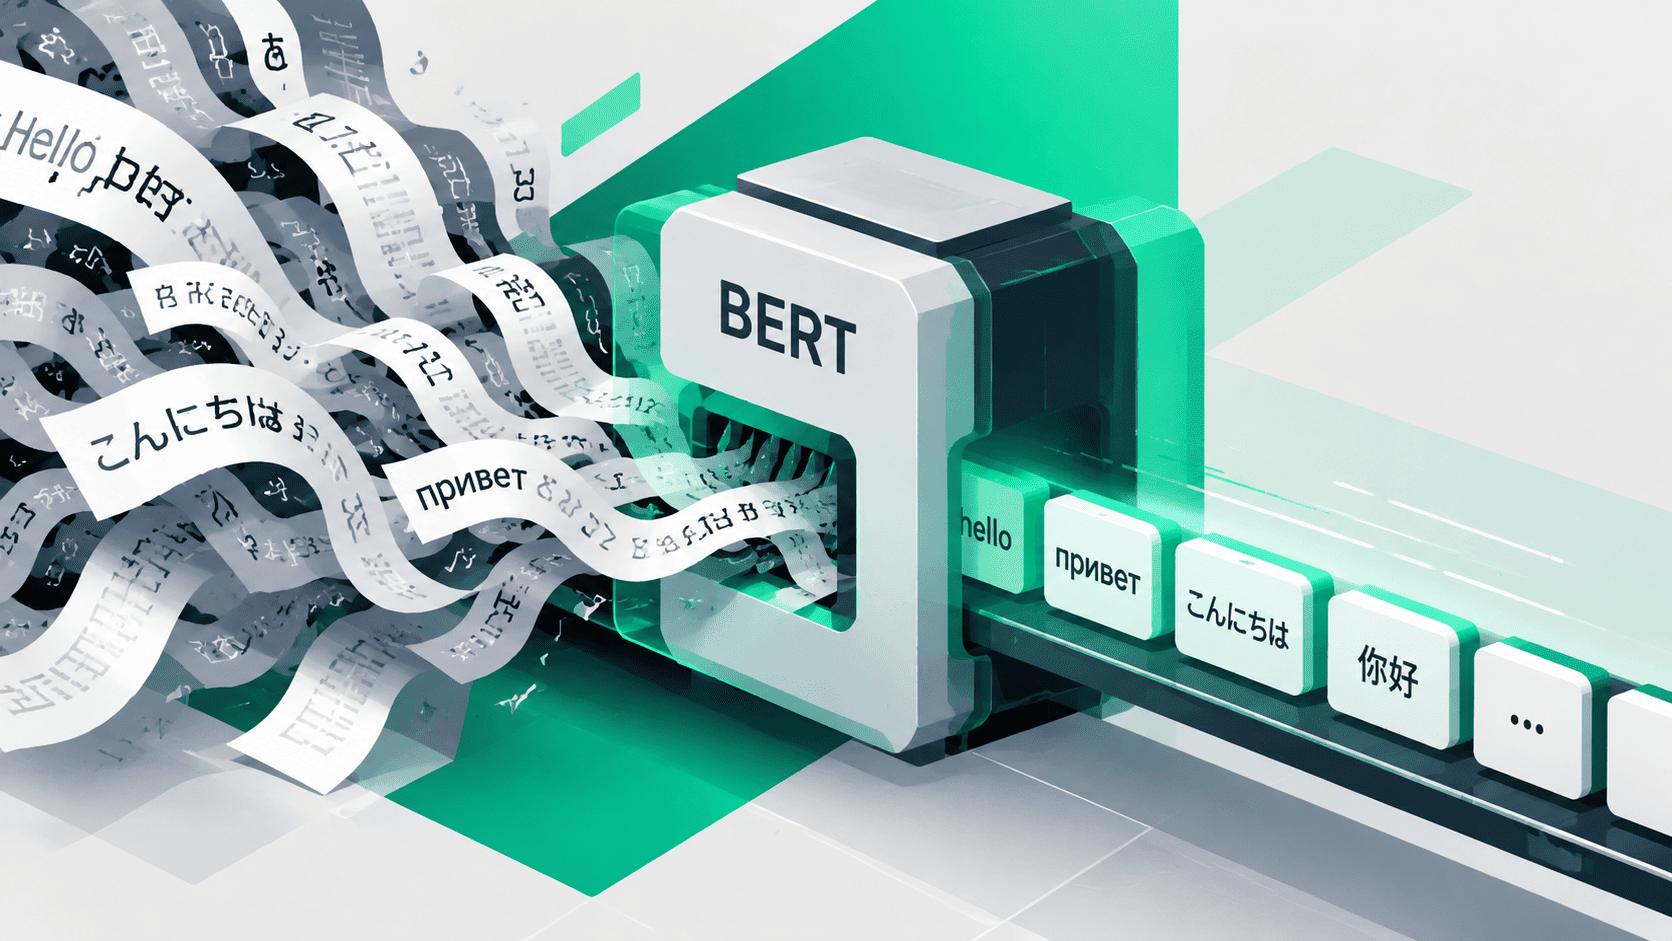
Даже проверка обычных символов может стать узким местом в обработке текста для языковых моделей. При профилировании bert-base-uncased выяснилось, что на нормализацию уходило 88% времени токенизации. В статье разбираемся, как SIMD‑инструкции, кеширование Unicode и пропуск лишних операций помогли ускорить обработку примерно в 50 раз, почему на разных языках результаты отличаются и где у такого подхода есть ограничения. Разобрать оптимизацию
Описание из RSS. Читать у источника →

Читайте также

Похожие новости

Цифровой нацизм. Нейросети наказывают за незнание английского – запросы на других языках дороже до 17 раз

Современные нейросети расходуют больше токенов, если запрос сделан не на английском языке. Это общемировая проблема – неважно, на каком язы…

Поиск по Loople

Назад