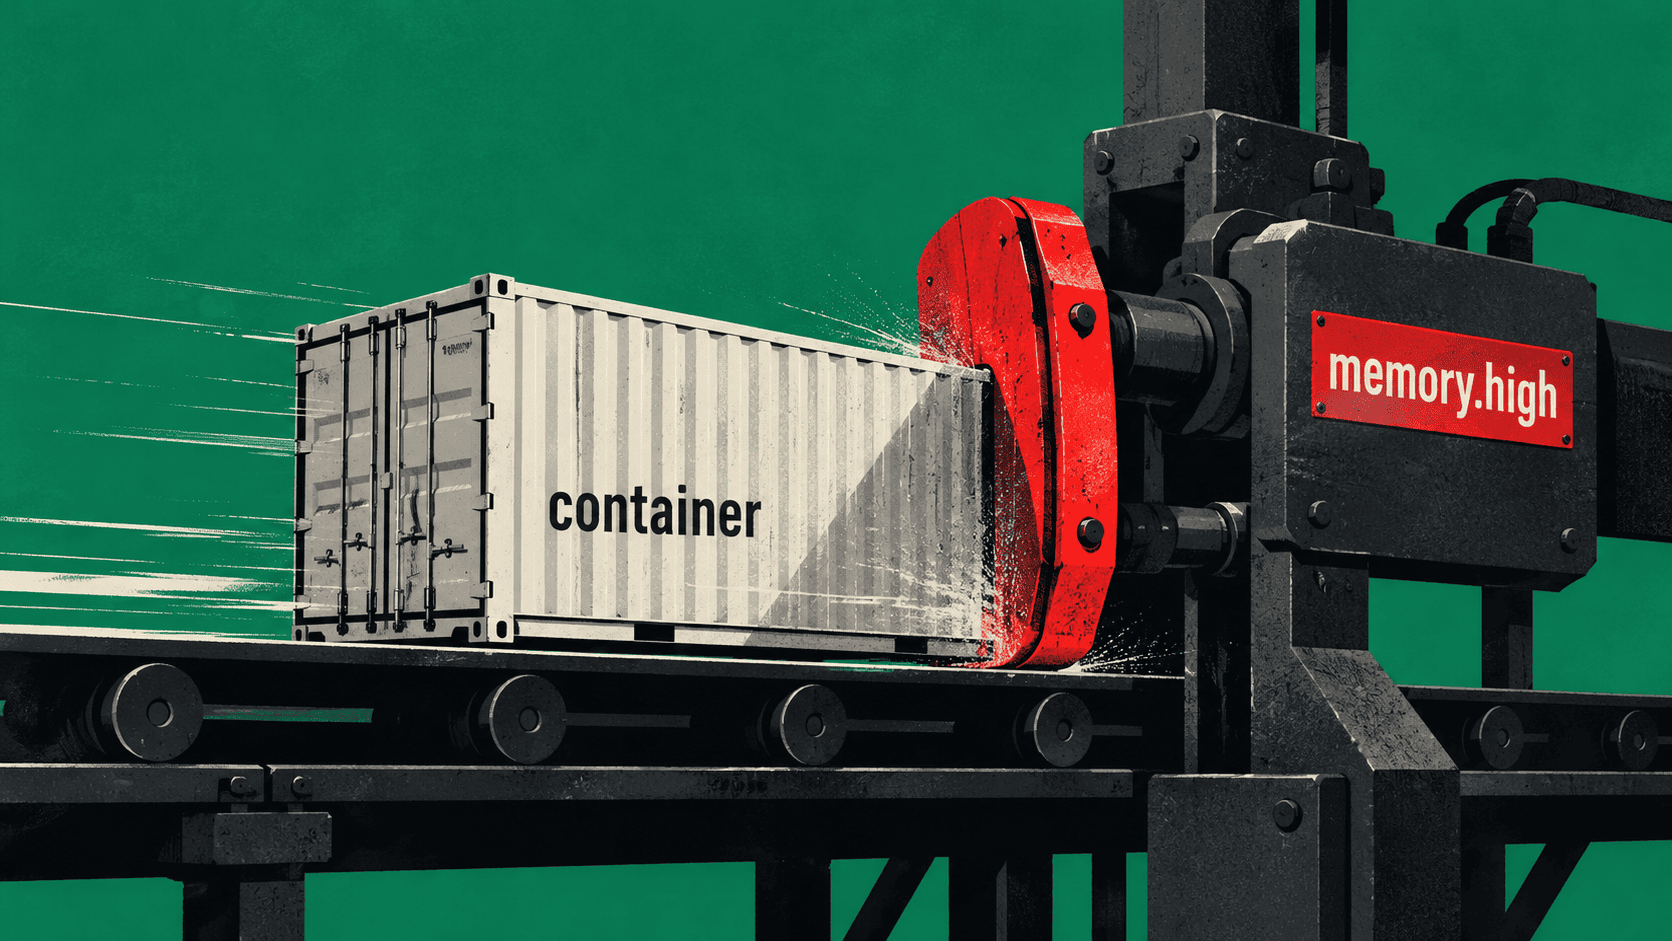
В Linux с использованием cgroup v2 для управления памятью существует два порога: memory.max, который жестко ограничивает потребление и вызывает убийство процесса через OOM killer при превышении, и memory.high, являющийся мягким лимитом. При выходе за порог memory.high ядро не убивает процессы, а отправляет их в режим принудительного освобождения памяти или усыпляет, если освобождать нечего. В Kubernetes 1.37, выпущенном 26 августа, функционал Memory QoS перешел в статус беты и включился по умолчанию. Для активации мягкого ограничения достаточно добавить в конфиг kubelet параметр memoryThrottlingFactor: 0.9, что позволяет контейнеру притормаживать вместо немедленного падения.
Автор статьи провел эксперименты на ядре Linux 6.8, показав разницу в поведении процессов. При жестком лимите 128 МБ процесс, потребляющий 256 МБ, получал сигнал SIGKILL и завершался мгновенно. В режиме с memory.high=128 МБ без жесткого потолка процесс не умирал, но его производительность резко падала: выделение 16 МБ памяти за порогом занимало более двух минут вместо 70–110 мс. Процесс переходил в состояние ожидания (State: D), простаивая и потребляя процессорное время на попытки освобождения памяти, которая не могла быть вытеснена из-за отсутствия swap. Штраф за перерасход растет квадратично и может достигать двух секунд на возврат в пользовательский режим, что приводит к задержкам в 8 секунд на мегабайт при определенных условиях.
В Kubernetes механизм работает следующим образом: для контейнеров с заданным лимитом памяти порог memory.high рассчитывается как requests.memory + memoryThrottlingFactor * (limits.memory - requests.memory). Если контейнеру не указан запрос, Kubernetes копирует в него лимит, и мягкого порога не создается. При превышении порога соседние процессы в той же группе также начинают страдать от задержек, так как штраф платит тот, кто запрашивает новую порцию памяти. Это может привести к тому, что сервис начнет тормозить, а не падать, что затрудняет диагностику утечек памяти. В отличие от systemd, где сторож systemd-oomd может убить задыхающуюся группу, в Kubernetes по умолчанию swap выключен, и убийство происходит только при достижении жесткого лимита memory.max или истечении grace period при перезапуске через liveness probe.
Несмотря на то, что Memory QoS в Kubernetes 1.37 работает как бета, он предлагает альтернативу немедленному рестарту контейнеров при утечках памяти. Вместо статуса OOMKilled контейнер переходит в состояние Running с высокой задержкой, что позволяет выявить проблемы позже, но может скрыть медленные утечки, которые проявляются в виде роста p99 и других метрик производительности. Документация ядра и Kubernetes в некоторых местах содержит противоречивые описания роли memory.high и memory.max, однако практика показывает, что связка мягкого лимита и внешнего сторожа эффективнее предотвращает катастрофические сбои, чем жесткое ограничение, которое просто убивает процесс.