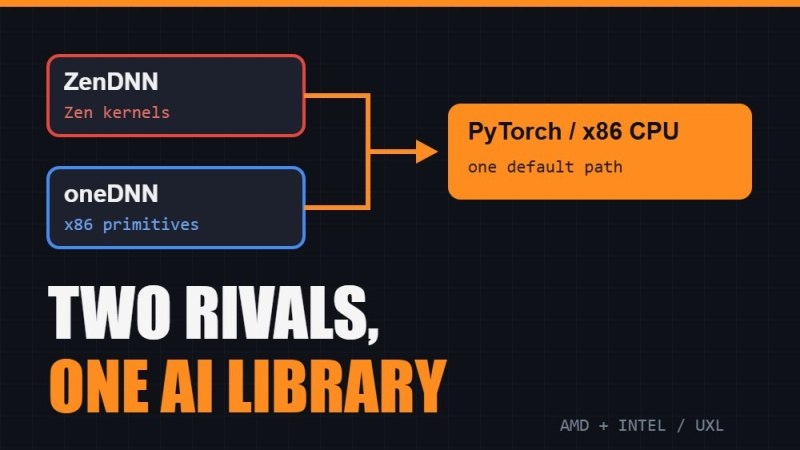
Компании AMD и Intel договорились о сотрудничестве в сфере разработки программного обеспечения для искусственного интеллекта. В рамках соглашения AMD прекращает поддержку отдельной библиотеки ZenDNN и передаст свои оптимизации в общую библиотеку oneDNN, созданную Intel. Это решение направлено на повышение эффективности работы ИИ-моделей, оптимизированных под фреймворк PyTorch и архитектуру Nvidia, на центральных процессорах x86 обеих компаний без необходимости дополнительных настроек. Теперь единая библиотека будет автоматически выбирать оптимальный путь выполнения операций в зависимости от используемого процессора, устраняя неудобства для разработчиков, которые ранее должны были следить за версией библиотеки в смешанных парках оборудования.
Проект oneDNN изначально разрабатывался Intel как набор вручную оптимизированных примитивов для глубокого обучения, таких как свёртки и матричное умножение, и использовался платформами PyTorch, TensorFlow, ONNX Runtime и OpenVINO. AMD ранее создала форк ZenDNN, сохранивший API oneDNN, но оптимизированный для архитектуры Zen, что обеспечило высокую производительность на процессорах EPYC, но создало дублирование кодовых баз. Совместная работа над унификацией стала первым прямым результатом деятельности «Консультативной группы по экосистеме x86» (x86 Ecosystem Advisory Group), созданной компаниями в конце 2024 года для предотвращения расхождения наборов инструкций ISA.
Помимо унификации библиотек, компании сообщили о совместной работе над AI Compute Extensions (ACE) — новым набором инструкций для матричного умножения в архитектуре x86. Поддержка ACE в PyTorch будет реализована в будущих обновлениях oneDNN, а компилятор GCC 17 уже получил совместимость с этими инструкциями. Использование единой библиотеки позволяет централизованно внедрять поддержку новых вычислительных ядер и избегать дублирования усилий. Стоит отметить, что договорённость касается только центральных процессоров; в сегменте графических процессоров AMD продолжает развивать независимый стек ROCm для интеграции с PyTorch, не рассматривая экспериментальную поддержку GPU через SYCL в oneDNN как замену для ускорителей серии Instinct.
Управление проектом oneDNN теперь осуществляется в рамках фонда UXL Foundation, созданного в сентябре 2023 года под эгидой Joint Development Foundation и Linux Foundation. Занятие руководящей позиции в проекте AMD подтверждает нейтральный статус библиотеки, хотя основная часть кода была написана инженерами Intel. Для пользователей, работающих с процессорами Ryzen или серверами на базе EPYC, интеграция оптимизаций ZenDNN в одинDNN станет незаметной, но значимой: стандартная версия PyTorch начнёт эффективно использовать возможности архитектуры Zen без установки дополнительных плагинов. Конкретные сроки интеграции первых фрагментов кода ZenDNN пока не называются.