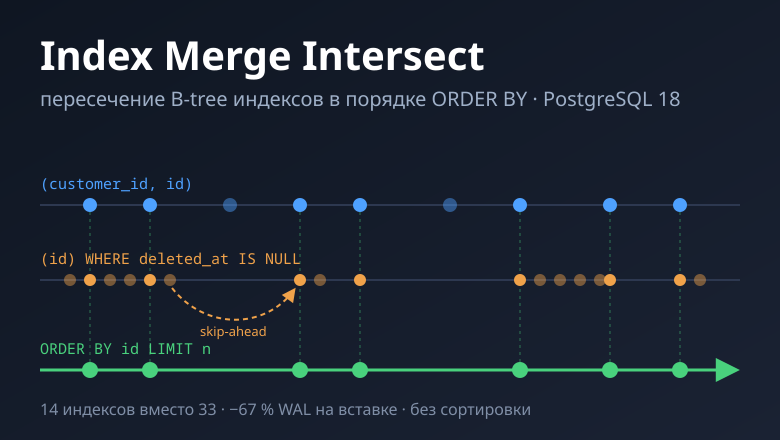
Разработано расширение PostgreSQL 18 под названием postgresql-leapfrog, которое добавляет в планировщик базы данных новый узел Index Merge Intersect. Этот механизм позволяет выполнять упорядоченное пересечение нескольких обычных B-tree индексов с остановкой на достижении лимита LIMIT, устраняя необходимость создания отдельных составных индексов для каждой комбинации фильтров. Автор проекта, не являющийся программистом на C, написал код расширения с помощью ИИ-агента Claude Code под своим руководством, задавая требования, логику и тесты, но не может самостоятельно оценить корректность C-кода, поэтому ищет ревью сообщества.
Проблема, которую решает расширение, заключается в том, что стандартный PostgreSQL не умеет соединять индексы, сохраняя порядок сортировки, что приводит к неэффективному чтению строк из основной таблицы (heap) или полной сортировке результатов. Новый алгоритм синхронно читает несколько индексов в порядке сортировки, переходя в heap только для строк, прошедших все условия, и останавливается сразу после получения нужного количества записей. В качестве примера приведена таблица заказов с общими индексами, где расширение позволяет выполнить запрос на последние 100 удаленных заказов покупателя за 1.9 мс, используя 100 чтений из heap, в то время как стандартные планы (Index Scan или BitmapAnd) требуют значительно больше времени и операций.
В части записи данных расширение демонстрирует существенное преимущество за счет уменьшения количества индексов. На бенчмарке с 500 000 строк и 12 колонками-фильтрами схема с общими индексами (14 штук) в сочетании с расширением обеспечивает запись в 5.7 раза быстрее, чем схема со специализированными индексами (33 штуки), при этом объем индексов сокращается на 67%. Также отмечается, что при записи мягкое удаление и обновления генерируют меньше записей в WAL, так как не требуют обновления множества составных индексов, необходимых для специализированных схем.
Для обеспечения корректности работы реализован механизм Skip-ahead, позволяющий потокам пропускать большие промежутки данных, если они не содержат совпадений, а также сопоставление строк по физическому адресу (TID) для корректного слияния при наличии мёртвых версий. Тестирование включает 14 регрессионных наборов, проверяющих работу с дубликатами, мёртвыми записями и различными типами данных, а также 11 изоляционных наборов для проверки конкурентности в условиях EvalPlanQual, HOT-обновлений и блокировок. Версия расширения составляет 0.0.3 и рассматривается как экспериментальная.