Актуальность вопроса соблюдения 152-ФЗ при использовании искусственного интеллекта в работе растет, так как сотрудники все чаще загружают конфиденциальные данные, включая юридические документы, в публичные чаты с ИИ. В России за 2025 год объем корпоративных данных, уходящих в такие системы, вырос в 30 раз. Последствия утечек могут быть серьезными: летом 2026 года суд Москвы отказал в взыскании 5 млн рублей по «золотому парашюту» директору по продажам, которая разглашала коммерческую тайну, загружая отчеты в нейросеть DeepSeek. При этом многие облачные сервисы для обезличивания документов сами требуют передачи данных в интернет, что не решает проблему приватности.
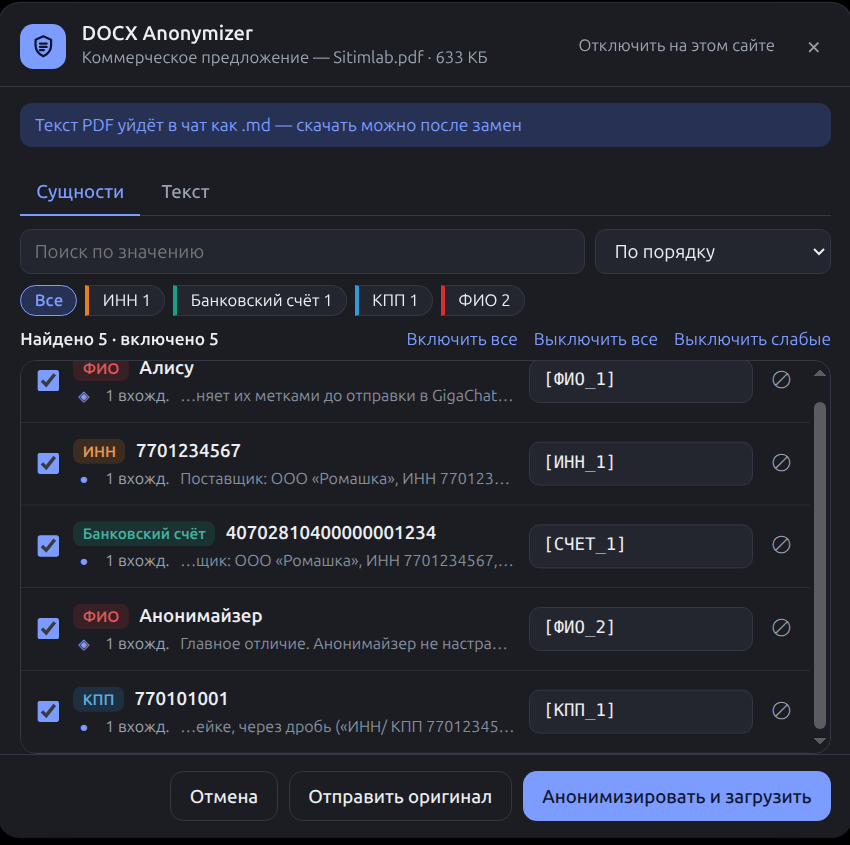
Для решения этой задачи разработчик создал расширение для браузера Chrome, которое перехватывает текстовый документ на странице чата с ИИ и на лету обезличивает его, не отправляя исходные данные в сеть. Проект написан на JavaScript и работает полностью локально без серверов, телеметрии и обязательной публикации в Web Store. Расширение использует детерминированные методы и базу знаний для поиска персональных данных, таких как ИНН и названия сторон договора, но имеет ограничения по работе со сложными текстами, где возможны ложные срабатывания или пропуски.
В основе обработки лежит небольшая модель rubert-tiny2, работающая в браузере через WASM в одном потоке воркера расширения. Для повышения эффективности модель была дообучена на данных WikiANN и factRuEval, а также на синтетических данных, имитирующих деловую переписку. После квантования весов модели в формате int8 ее размер составил 30 МБ, что позволяет обрабатывать 20 страниц договора примерно за 1,7 секунды. Разработчик также реализовал механизм ручной верификации найденных организаций, так как автоматическое распознавание сложных названий остается сложной задачей.
Сейчас расширение доступно в открытом виде на GitHub, а его функционал продолжает развиваться. Разработчик планирует добавить поддержку дополнительных датасетов, таких как Nerus и NEREL, улучшить работу с английским языком и рассмотреть вопрос публикации в Web Store. На данный момент инструмент поддерживает PDF с текстовым слоем, но не работает со сканами. Автор подчеркивает, что это не замена внутренней политике компании по работе с ИИ, а способ минимизировать риски на коротком пользовательском пути, позволяя обезличивать документы непосредственно в интерфейсе чата.