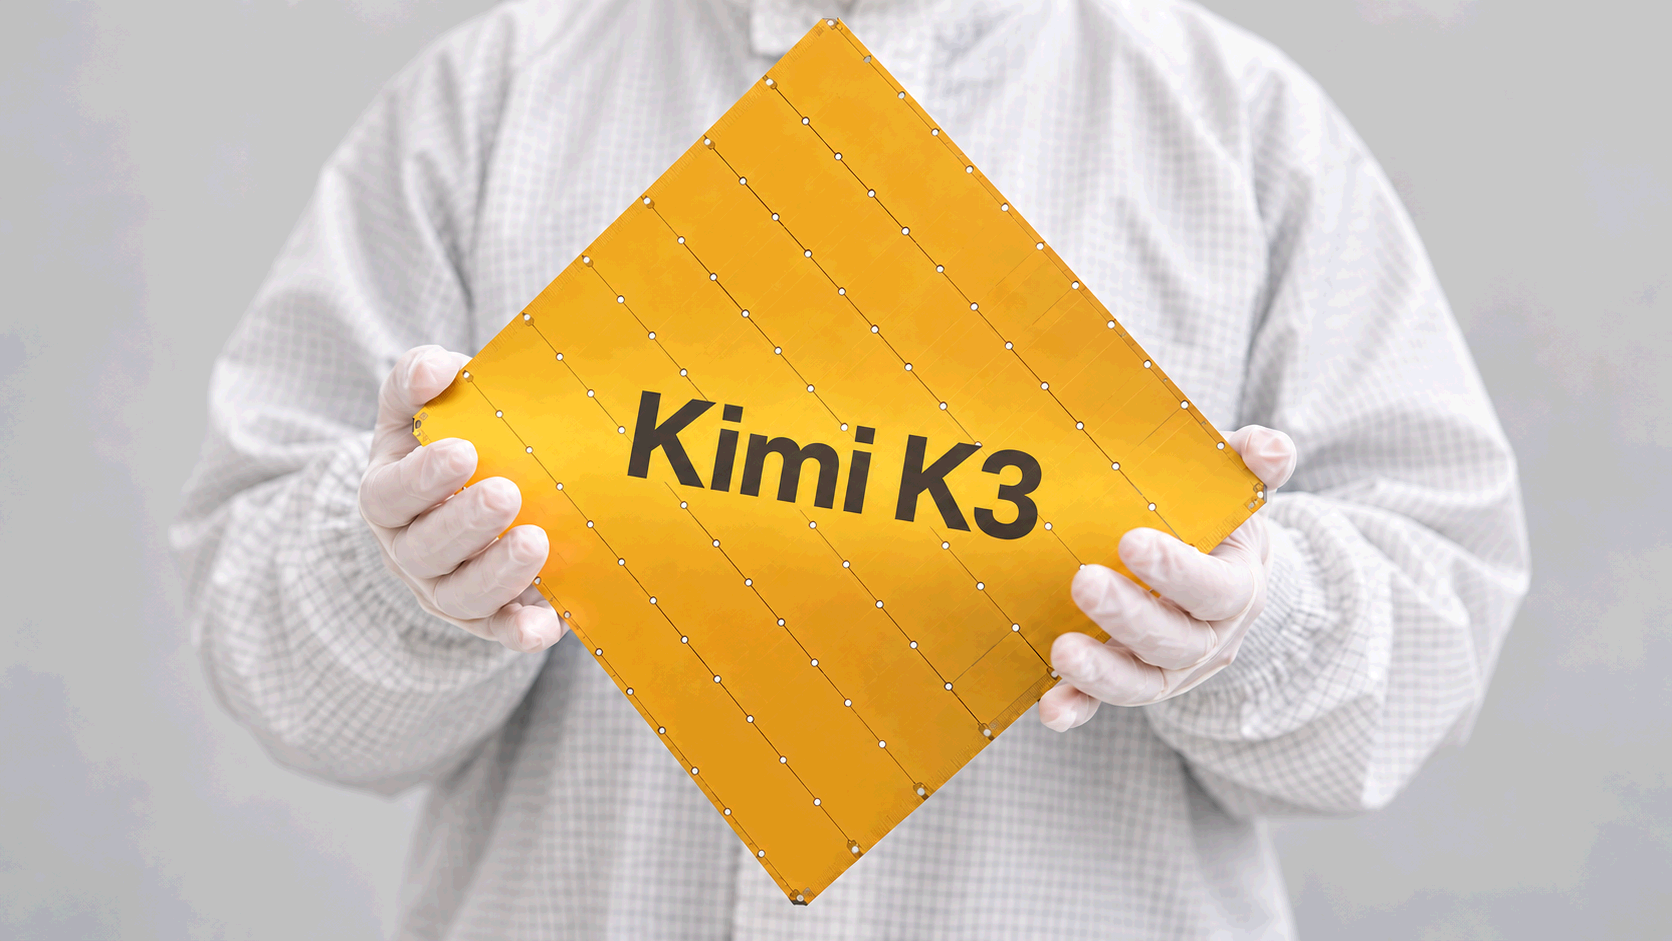
Развертывание больших языковых моделей на специализированных чипах Cerebras требует особого подхода к распределению памяти, так как одна пластина WSE-3T обладает всего 44 ГБ встроенной памяти, что недостаточно для хранения весов моделей с триллионами параметров. В качестве примера рассмотрена открытая модель Kimi K3, содержащая около 3 трлн параметров, 69 слоев линейного внимания и 24 слоя полного внимания. Для запуска этой модели на скорости 1000–2000 токенов в секунду применяется 4-битная квантизация весов и 8-битный KV-кэш, что позволяет разместить веса модели на нескольких пластинах, объединенных в вычислительный конвейер.
Для расчета необходимого количества пластин весов модели объемом 1,5 ТБ делятся на 93 слоя, что дает примерно 16 ГБ на каждый слой. Слои полного внимания занимают всю доступную память пластины под себя и KV-кэш, поэтому на одной пластине размещается один такой слой. Слои линейного внимания требуют меньше памяти и позволяют разместить два слоя на одной пластине. В результате для Kimi K3 требуется 35 пластин для линейных слоев и 24 пластины для слоев полного внимания, в сумме 59 пластин. Вычисления между пластинами передаются через RDMA поверх Ethernet с задержкой около 2 микросекунд, при этом веса остаются на чипах, а передаются только активации.
Обработка запросов в системе строится по принципу конвейера, где каждая пластина выполняет вычисления для своего слоя, передавая активации следующему этапу. Это позволяет параллельно обрабатывать множество запросов: пока один этап работает с токеном запроса A, другой — с токеном запроса B. Количество одновременных запросов ограничено объемом памяти под KV-кэш. На каждой из 24 пластин с полным вниманием остается 28 ГБ памяти для кэша (44 ГБ минус 16 ГБ на слой). Для контекста в 256 тысяч токенов один запрос занимает около 147 МБ на слой, что позволяет поддерживать примерно 190 одновременных запросов на пластине с полным вниманием.
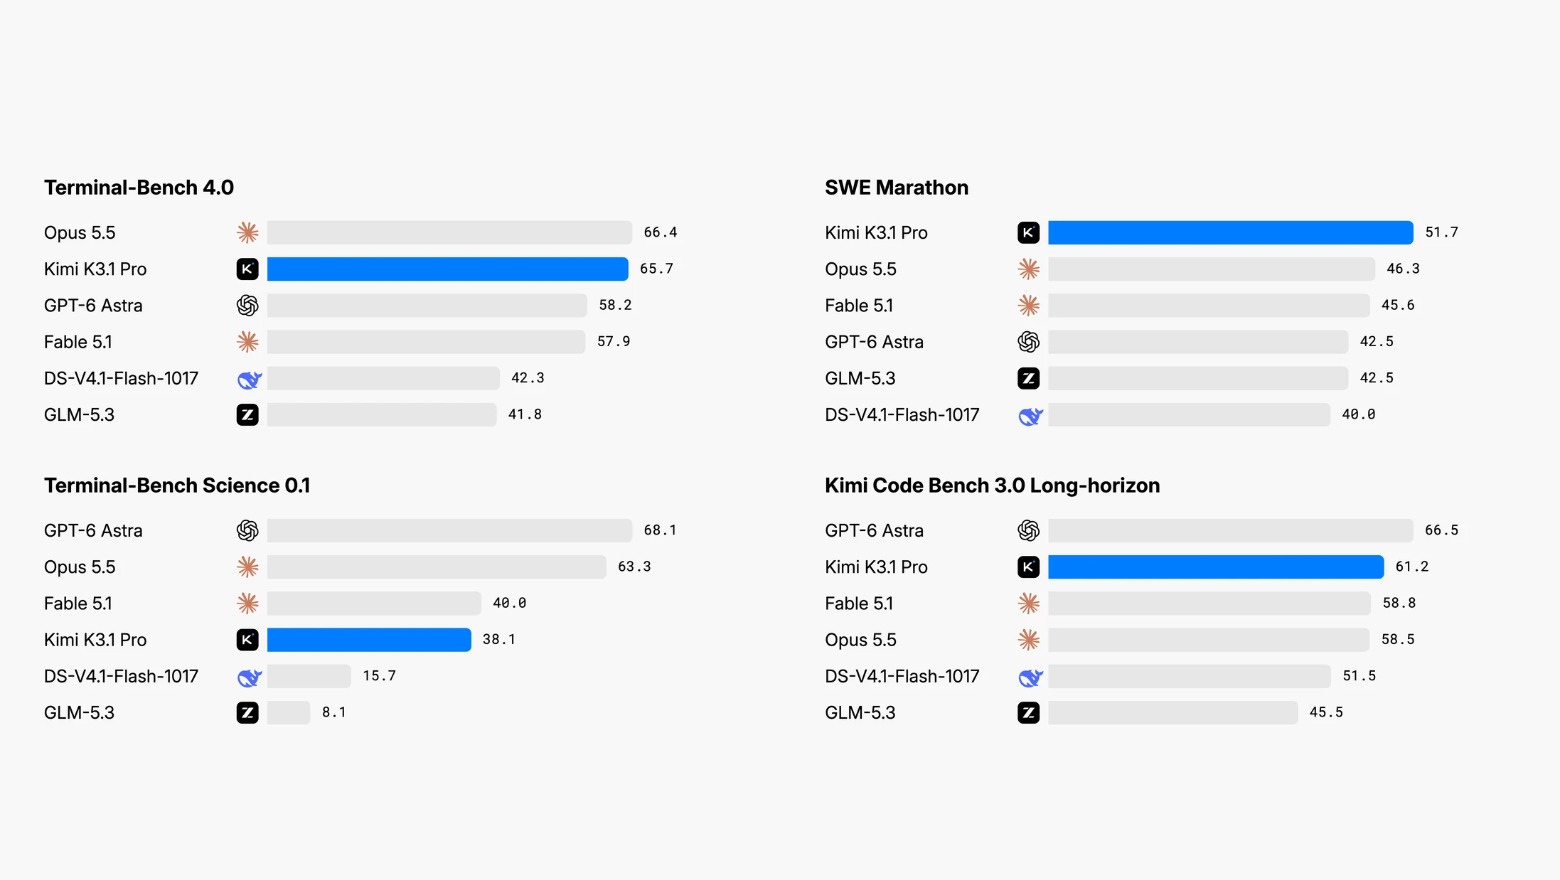
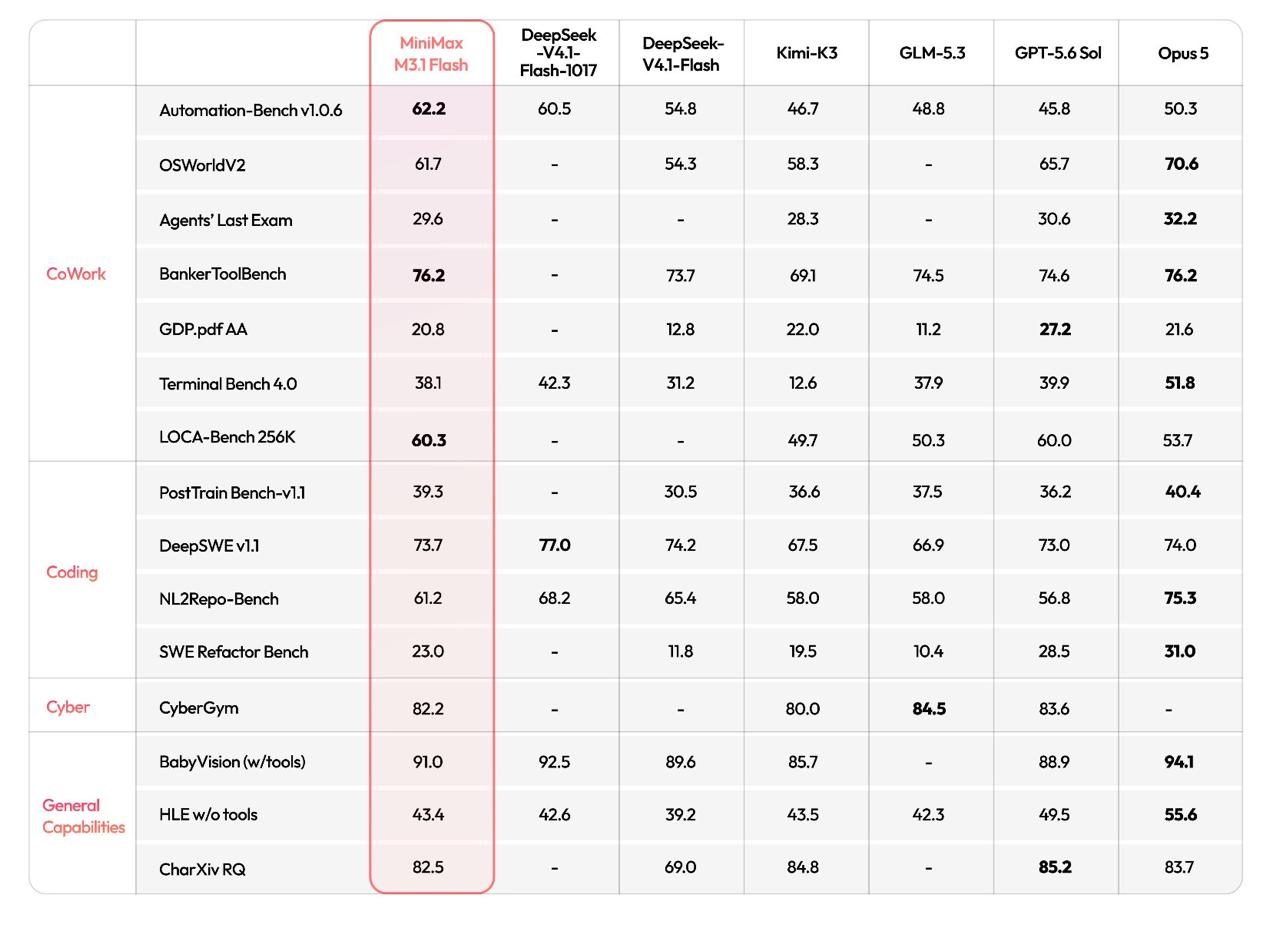
Этот метод масштабируемости позволяет запускать модели размером более 3 трлн параметров, добавляя дополнительные пластины для увеличения вычислительных ресурсов и памяти. Эффективность системы оценивается не только количеством параллельных запросов, но и суммарной скоростью генерации токенов на единицу мощности. Такой подход демонстрирует возможность запуска передовых моделей, таких как Kimi K3, показавшей результаты на уровне GPT-5.6 Sol, на локальном оборудовании с высокой пропускной способностью.